vLLM 论文学习笔记
论文链接: https://arxiv.org/abs/2309.06180
Introduction
背景
自回归过程很贵,让程序memory-bound,所以引入batch。
为了batch更大,内存管理很关键。大约30%的内存被KV cache占据。
现在的LLM服务框架管理内存不够高效,原因:将kv cahce放入连续的内存中。
KV cache的特点:
请求进来的时候,系统不知道KV cache会存在多长时间,最终会多大。
这一特点造成的问题:
- 传统系统会预留可能的最大空间,这个空间最后很可能用不上;即使最后用上了,在推理过程中的很长一段时间,这个空间处于闲置的状态;而且从外部看,GPU显存也会有external fragmentation的问题。
- 传统系统不能共享KV cache的前缀,因为它要保证KV Cache连续。在并行采样算法中,前缀是一样的,可以重复利用KV cache。
PagedAttetion核心思想:像操作系统一样,将block当成page,token当成byte,request当成process;所有block大小一致,减轻external fragmentation。
Preemptive request scheduling 与pagedAttention协同设计。
Background
Iteration-level scheduling:每生成一轮token就重新调度,batch是动态变化的。
LLM service的两个阶段:
- prompt phase:生成第一个token和kqv
- The autoregressive generation phase:用之前所有生成的token生成下一个token,复用之前的KV。
Batching技术的现有问题:
- 需要等待请求到来和上一个请求结束
- 请求的推理长度不一样
解决方案:fine-grained batching mechanisms。好处:
- 请求只需等待一轮token生成
- 调度机制+支持不等长序列的special GPU kernels消除padding影响。
LLM Serving的内存管理难点:
- KV Cache很大
- Beam search的共享KV Cache是变化的
- 当空间不足时删除或swap out KV Cache。
Method
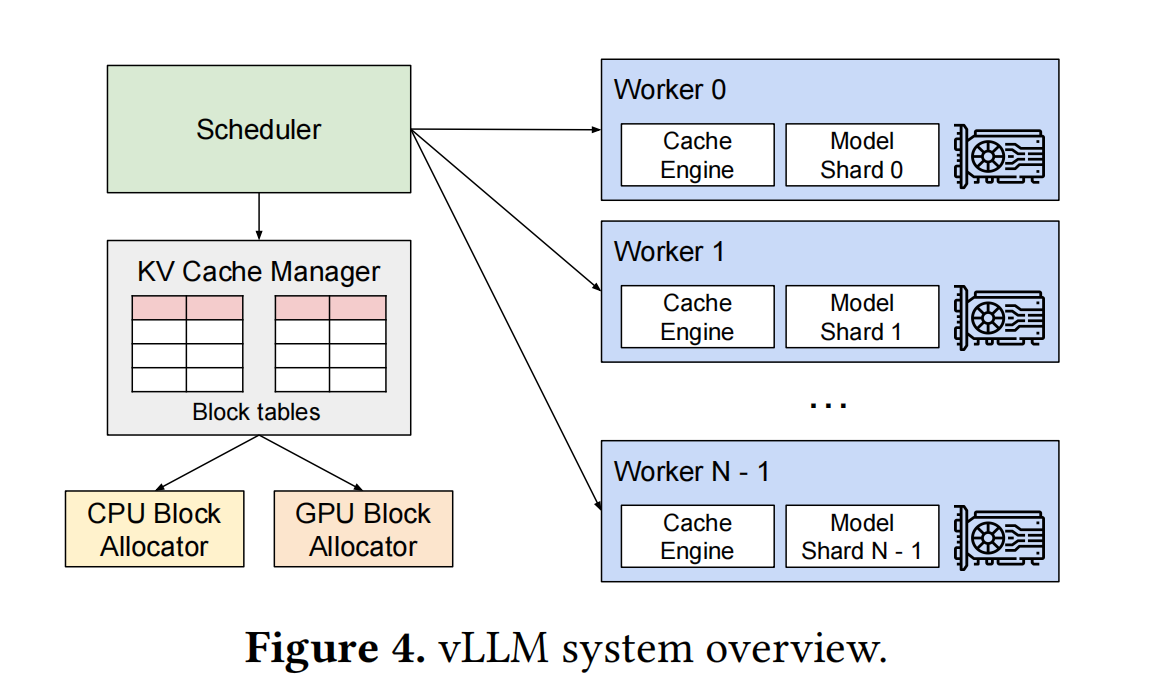
Scheduler:调度分布式GPU
KV Cache manager:根据调度器的指令管理KV Cache。
PagedAttention
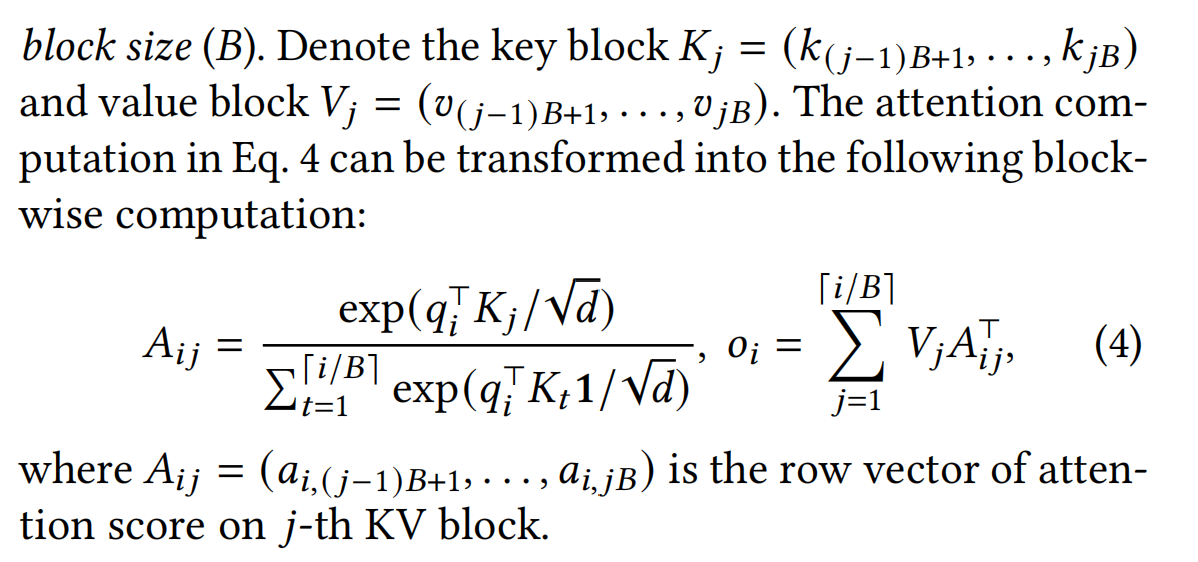
先对KV分块,块大小为B,则有公式:
KV Cache Manager
将内存划分成逻辑连续,物理上成多个分散的块。
block engine会分配一段连续的GPU DRAM,并划分成若干个物理的KV Block,CPU RAM同样,用于swapping。
维护一个block tables,记录逻辑和物理block的映射,并记录block内已经使用的大小。
一个decoding 迭代的步骤:
- 选择一些序列组成batch
- 为新请求的逻辑块分配物理块
- 拼接token
- 跑forward
- 读取旧KV
- 写入新KV
Parallel sampling
可以共享相同前缀的KV Cache
最后一个块出现分歧时,使用copy-on-write新开一个块。
Beam search中,不仅可以共享prompt,还有同台变化的更多共享模式。
Shared prefix
对于系统提示词可以预先储存共享KV缓存
Mixed decoding methods
vllm可以同时处理不同的decode模式,因为vllm使用统一的映射层,隐藏逻辑与物理块的复杂关系。
调度
使用first come first serve策略
如果所需KV Cache内存超出了显存:
以序列为单位进行两种调度:swapping和recomputation。具体用哪种取决于带宽和算力。
swapping:将显存的kv缓存放到cpu内存中,一旦发生了preempt,不接受新的请求,保证内存占用不大于显存占用。
recomputation:将kv cache直接释放,用到时再重新批量计算。
分布式执行
分布式模型计算:Attention的每个head是独立计算的;每个GPU负责一部分head的计算。Single Program Multiple Data模式,Megatron-LM风格tensor parallelism。
分布式KV Cache存储:每个GPU只需要保存自己负责的heads对应的KV
KV Cache管理和地址映射是中央scheduler统筹:每个GPU上的映射关系一样,只是储存的内容不一样。
整体架构:
Central Scheduler: 负责request 调度; KV Cache Manager; Block Table
|
| broadcast 控制信息
↓
|——GPU0:heads 0~7; kv shard 0
|——GPU1:heads 8~15; kv shard 1
|——GPU2:heads 16~23; kv shard 2
(GPU计算过程中使用all-reduce同步)
完整执行过程
- scheduler首先构造control message:当前batch中每个请求的input token ids和block table。
- scheduler将message广播给所有GPU
- GPU workers开始执行
- Attention层中,各worker根据block table读取KV Cache
- 使用all-reduce同步中间计算结果
- 最后,各worker将这一轮的sample tokens返回给scheduler形成循环
Implementation
vllm整体架构
vllm是端到端的大模型推理服务系统,组成:
- FastAPI前端:扩展了OpenAI 风格的API风格的接口,可以每个请求单独设置采样参数。
- GPU推理引擎:Python负责Scheduler、Block Manager、其他逻辑控制;CUDA C++负责PagedAttention算子;GPU通信使用NCCL;复用pytorch和Transformers能力。
用户请求
↓
FastAPI / OpenAI-style API
↓
Scheduler
↓
Block Manager / Paged KV Cache
↓
PyTorch Model Executor
↓
Custom CUDA PagedAttention
↓
NCCL multi-GPU communication
Kernel 优化
Fused reshape and block write:将新KV cache分成块,reshape成交适合读取的形状,写入内存。
Fusing block read and attention:直接根据block table从分页KV Cache中取K/V,然后马上计算attention,而不是先把K/V整理成连续内存。一个warp专门处理一个block,实现合并访存。
Fused block copy:不连续block的copy被batch成一次kernel launch
性能评估与消融实验
相比当时先进的Orca类方案,其吞吐量通常提升约2–4 倍
vLLM的注意力内核延迟比高FasterTransformer高20%–26%,但更高的批处理能力和显存利用率可以抵消
块太小,难以充分并行,管理开销更高;块太大,内部碎片增加,共享机会减少;大小默认为16token
块较小,带宽利用率低,重计算划算;块较大交换划算;块在16-64之间,表现相当。
讨论
分页适合:内存需求动态;性能受显存影响;提升利用率可以增加并发的场景。
| 最大并发 | 请求吞吐 | 输出吞吐 | 平均 TTFT | 平均 TPOT | 平均总延迟 |
|---|---|---|---|---|---|
| 1 | 3.73 req/s | 238.70 tok/s | 15.36 ms | 4.01 ms | 267.94 ms |
| 8 | 24.68 req/s | 1579.51 tok/s | 23.62 ms | 4.73 ms | 321.62 ms |